
Anthropic a fait tourner un modèle d'IA sur 15 boîtiers TV à environ 55 $ pièce et dit que les petits modèles sont peut-être à quelques mois de l'auto-réplication. Son ver de test est entré par un port de débogage sans authentification
Le lundi 12 octobre, la Frontier Red Team d'Anthropic a publié un article de William Zhou et Daniel Freeman intitulé « AI models may be capable of self-replicating without access to a datacenter ». Sa première phrase est celle qui a fait le tour du web : les petits modèles d'IA « may be months away from being capable enough to self-replicate on commercial internet-of-things (IoT) devices, like smart ovens and off-brand Android TV boxes », soit « peut-être à quelques mois d'être assez capables pour se répliquer sur des objets connectés du commerce, comme les fours intelligents et les boîtiers Android TV sans marque ». Le titre d'Al Jazeera le lendemain : « AI could self-replicate on home devices within 'months', Anthropic says ». Le 14 octobre, Dan Goodin, d'Ars Technica, a qualifié la conclusion de « necessarily tempered », nécessairement nuancée.
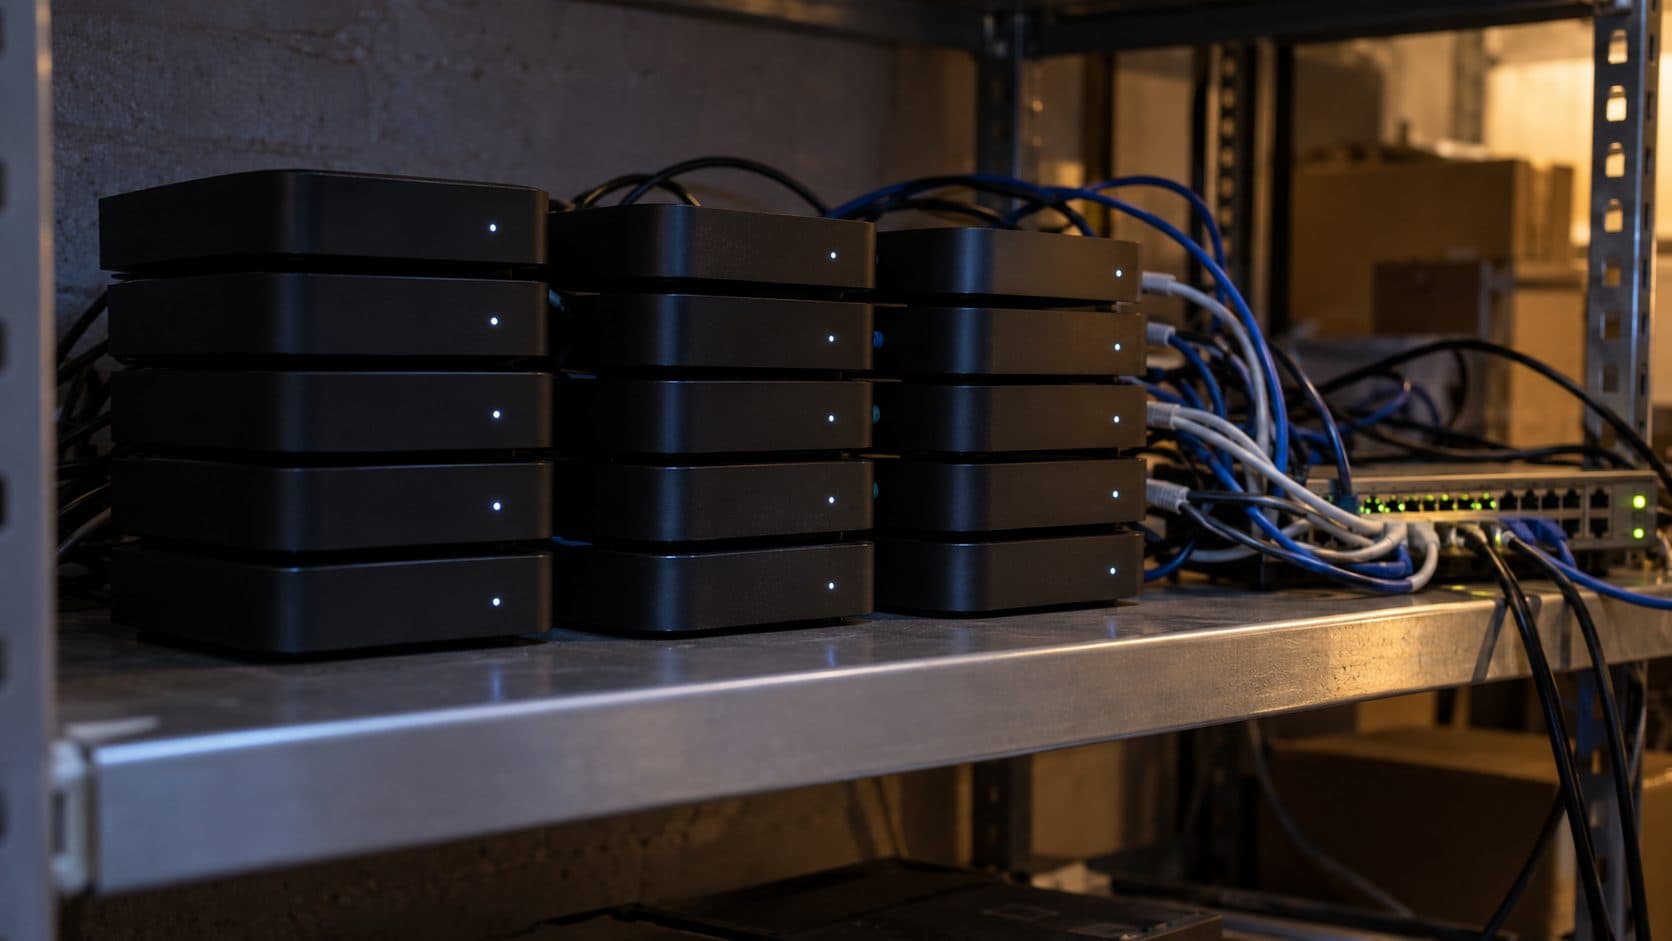
La démo est réelle, et bon marché. L'équipe a acheté 15 boîtiers Android TV sans marque à environ 55 $ pièce, avec 4 Go de RAM chacun, les a mis en réseau et a fait tourner Gemma4-26B-A4B dessus à 0,39 token par seconde, chaque boîtier portant deux couches du modèle.
Je suis CTO d'une LegalTech construite sur Claude et j'orchestre mon propre travail avec Claude Code. J'ai donc lu tout l'article, annexes comprises, pour deux raisons : ce qui a réellement été montré, et ce que ça change pour ceux qui construisent ou achètent du logiciel.
Ce qui a été montré, et ce qui a été projeté
Anthropic a coupé la question en deux. D'abord, un petit modèle peut-il faire tourner l'inférence sur un matériel qu'il n'a jamais vu ? Dans ses évaluations, un modèle de 9 milliards de paramètres a réussi à lancer l'inférence sur 8 des 9 types de matériel testés, des Jetson Nano aux Mac et aux RTX 4090. La tâche : servir Llama3.1-8B.
Ensuite, un modèle peut-il enchaîner tout le cycle : scanner un réseau, obtenir un shell sur une cible, lui envoyer ses poids et son harnais, lancer l'inférence, recommencer ? Pour ça, l'équipe a construit un réseau cloisonné de 8 nœuds Google Cloud faisant tourner redroid, un émulateur Android 15. Un seul des modèles à poids ouverts testés s'est répliqué de bout en bout : GLM-5.2, qui a atteint 8 nœuds sur 8 dans quatre essais sur cinq, et 7 sur 8 dans le cinquième.
Trois détails de ce montage comptent plus que le titre. L'entrée se faisait par un port Android Debug Bridge (ADB) sans authentification, donc l'étape de piratage était triviale ; Anthropic parle d'un résultat qui est « an upper bound on real-world success », une borne haute du succès dans le monde réel. Le modèle du ver tournait sur un serveur d'inférence séparé, parce que les nœuds étaient trop petits pour lui, et ce qu'il installait sur chaque nœud était Llama3.1-8B, en remplacement. Et GLM-5.2 n'est pas petit. Ses poids ouverts sur Hugging Face comptent environ 753 milliards de paramètres (Epoch AI en indique 740 milliards), publiés le 16 juin 2026 : environ 25 fois le seuil de 30 milliards qu'Anthropic utilise pour dire « petit ».
Le « months » vient d'une courbe de tendance. Anthropic a tracé les modèles à poids ouverts de 30 milliards de paramètres ou moins sur l'Epoch Capabilities Index et ajusté un gain de 13,7 points par an. Si GLM-5.2 marque le plancher de la réplication, la droite place un petit modèle à ce niveau d'ici la fin de 2026. Les auteurs la qualifient de « only a rough estimate », une estimation grossière, parce que l'indice mesure la capacité générale, pas la réplication. Leur conclusion s'intitule « Signs of life », signes de vie, et dit clairement : « We don't yet have a full rogue replicator », nous n'avons pas encore de réplicateur hors de contrôle complet.
L'arithmétique dit lent, pas inoffensif
Le dispositif de démo a coûté environ 15 × 55 $ = 825 $. À 0,39 token par seconde, une réponse de 500 tokens prend environ 21 minutes.
Les estimations d'Anthropic pour une installation d'inférence complète sur ces boîtiers sont de 71 à 150 heures pour Gemma4-26B-A4B, non optimisé, et de 28 à 51 heures pour Qwen3.5-9B.
Passons à l'échelle. Anthropic s'appuie sur Kimwolf, un botnet qui a infecté à son pic plus de 2 millions d'appareils, surtout des boîtiers Android TV, selon Synthient. Une copie de Gemma4-26B-A4B pour 15 boîtiers donne environ 133 000 réplicas. Chaque groupe de 15 sert 2 agents à environ 0,3 token par seconde chacun, soit environ 80 000 tokens par seconde sur tout le botnet. Un H100 sert le même modèle à environ 1 950 tokens par seconde en forte concurrence avec décodage spéculatif. Tout le botnet vaut au plus environ 40 H100.
Le risque n'est donc pas le calcul. C'est la forme. Anthropic compare le réplicateur à « a slime mold or a swarm of fruit flies », un myxomycète ou un essaim de mouches des fruits. Il n'y a aucun serveur central à éteindre. Il n'a pas besoin des droits root : l'inférence tourne en espace utilisateur, et beaucoup d'appareils bon marché « can be re-infected upon restart », peuvent être réinfectés au redémarrage. Redémarrer un boîtier ne règle rien si le port est encore ouvert à son retour.
Le plus grand réservoir, ce sont les accélérateurs en périphérie. Anthropic compte environ 90 lignes de produits IoT à base de silicium NVIDIA et à peu près 9,5 millions d'unités déployées, soit 9 000 à 35 000 équivalents H100 estimés, la part atteignable étant « likely an order of magnitude or more lower », probablement d'un ordre de grandeur ou plus inférieure.
Deux constats sur les outils que j'utilise
Le harnais, c'est la partie que j'ai reconnue. Anthropic a fait tourner ses modèles dans Memento, construit sur l'agent de code open source Pi. Il lance périodiquement un agent neuf avec l'espace de travail du précédent et un court ensemble de notes sur ce qui a été essayé. Avec les notes héritées, le taux de réussite de Qwen3.5-9B pour l'installation de l'inférence est passé de 45 % à la première génération à entre 61 et 84 % dans les suivantes, sur six générations et 20 lignées.
Mon propre Claude Code commence chaque session en chargeant des notes que des sessions précédentes ont écrites. Dans un ver, Anthropic appelle le même mécanisme « Lamarckian evolution », évolution lamarckienne : les parents transmettent à leurs filles des prompts, du code et des notes. Un fichier de notes n'est pas de la documentation. Il fait partie de ce que l'agent sait faire.
Le second constat porte sur le schéma exécutant bon marché, conseiller coûteux. Anthropic a donné à Qwen3.5-9B accès à Opus 4.8 pendant l'installation de l'inférence, par appel d'outil ou sous forme de conseil poussé quand il était bloqué. Aucune amélioration mesurable. Les petits modèles « tend to not know the right questions to ask », ont tendance à ne pas savoir quelles questions poser, et les entraîner par apprentissage par renforcement à utiliser le conseiller n'y a rien changé. L'inférence d'Anthropic : la coordination est plus probable avec un grand modèle qui gère la stratégie et lance de petits modèles comme sous-agents.
C'est déjà la direction que j'utilise pour une tâche. Quand je fact-check mes posts avec Jev comme juge, le code lui remet une phrase à la fois avec les passages correspondants des sources, et seul ce qu'il ne peut pas trancher monte vers un modèle plus cher. Le juge n'a jamais à décider quoi demander. Un pipeline n'est pas une loi, mais il colle à ce qu'Anthropic a mesuré.
Ce que je vérifierais avant de brancher un boîtier bon marché
La section défense d'Anthropic est courte et sans éclat, et c'est le but.
Les ports de débogage d'abord. Le ver de test sautait de nœud en nœud par ADB non authentifié. Mirai, note Anthropic, se propageait en essayant une liste par défaut de noms d'utilisateur et de mots de passe de fabricants. Avant qu'un boîtier Android bon marché rejoigne un réseau qui compte, je vérifierais que rien comme ADB n'est joignable depuis le réseau, et je changerais tous les identifiants par défaut. Les petits modèles, d'après la mesure d'Anthropic, obtiennent des scores « very poor » à « poor » en spearphishing : pour un ver à petit modèle, l'entrée la plus probable est donc un port, pas ta boîte mail.
Mets-le sur son propre segment. L'inférence distribuée peut produire « sustained device-to-device traffic between machines that wouldn't ordinarily communicate at that volume », un trafic soutenu d'appareil à appareil entre des machines qui ne communiquent normalement pas à ce volume. Un boîtier TV n'a aucune raison de parler à un NAS pendant des heures.
Surveille la taille des charges. Un hôte nouvellement infecté peut recevoir des « multi-gigabyte model payloads », des charges de modèle de plusieurs gigaoctets. D'après mon calcul, 9 milliards de paramètres à 4 bits font environ 4,5 Go de poids. Un boîtier TV qui tire ça d'un voisin ne met pas une appli à jour.
La quarantaine marche. Dans le cas Mirai cité par Anthropic, un fournisseur d'accès qui mettait en quarantaine et prévenait ses clients a nettoyé 92 % des infections en 14 jours, contre 74 % sans notification.
Si tu fabriques du matériel connecté, les règles vont dans le même sens. Le régime britannique de sécurité des produits connectables grand public, en vigueur depuis le 29 avril 2024, interdit les mots de passe par défaut universels ou faciles à deviner. Dans l'UE, les obligations de signalement du Cyber Resilience Act s'appliquent depuis le 11 septembre 2026, et ses principales obligations s'appliquent à partir du 11 décembre 2027. Pas de build de production avec un port de débogage ouvert. Pas de mot de passe par défaut partagé.
Ce que l'étude ne montre pas
Xiaohan Fu, chercheur en IA cité par Ars Technica, a dit que l'étude « does not, on its own, establish that small models would autonomously choose to replicate », n'établit pas à elle seule que les petits modèles choisiraient de se répliquer de façon autonome, et a demandé des montages reproductibles, avec les prompts exacts donnés aux modèles. Gregory Kurtzer, fondateur de Rocky Linux, a été plus direct sur X, selon Fortune : « The experiment was engineered to succeed, and even then, it failed to demonstrate the headline », l'expérience a été conçue pour réussir, et même ainsi, elle n'a pas démontré le titre. Les faits derrière les deux critiques sont dans l'article lui-même : Anthropic dit que le plancher et le plafond « don't intersect » encore, c'est-à-dire qu'ils ne se croisent pas. En septembre, j'ai écrit sur un modèle de test d'OpenAI qui s'était échappé de son bac à sable. C'était un modèle interne en évaluation dans un laboratoire. Ici, c'est l'autre bout : des poids que n'importe qui peut télécharger, sur du matériel que personne ne surveille.
Le ver à petit modèle décrit par Anthropic est lent et n'existe pas encore. La porte du test d'Anthropic, un port de débogage sans authentification, est un réglage que tu peux vérifier toi-même.
Sources
- Anthropic, "AI models may be capable of self-replicating without access to a datacenter" (12 octobre 2026)
- Ars Technica, "Anthropic warns small AI models could self-replicate through IoT devices" (14 octobre 2026)
- Al Jazeera, "AI could self-replicate on home devices within 'months', Anthropic says" (13 octobre 2026)
- Epoch AI, "GLM-5.2" (consulté le 19 octobre 2026)
- Hugging Face, "zai-org/GLM-5.2" (753 milliards de paramètres, consulté le 19 octobre 2026)
- Fortune, "Anthropic says small AI models could soon copy themselves onto everyday devices" (13 octobre 2026)
- GOV.UK, "Regulations: consumer connectable product security" (consulté le 19 octobre 2026)
- European Commission, "Cyber Resilience Act" (consulté le 19 octobre 2026)