
Anthropic ejecutó un modelo de IA en 15 reproductores de TV a unos 55 $ cada uno y dice que los modelos pequeños pueden estar a meses de replicarse solos. Su gusano de prueba entró por un puerto de depuración sin autenticación
El lunes 12 de octubre, el Frontier Red Team de Anthropic publicó un artículo de William Zhou y Daniel Freeman titulado "AI models may be capable of self-replicating without access to a datacenter". Su primera frase es la que se difundió: los modelos de IA pequeños "may be months away from being capable enough to self-replicate on commercial internet-of-things (IoT) devices, like smart ovens and off-brand Android TV boxes", es decir, quizá estén a meses de ser lo bastante capaces para replicarse en dispositivos IoT comerciales, como hornos inteligentes y reproductores Android TV sin marca. El titular de Al Jazeera al día siguiente: "AI could self-replicate on home devices within 'months', Anthropic says". El 14 de octubre, Dan Goodin, de Ars Technica, calificó el hallazgo de "necessarily tempered", necesariamente matizado.
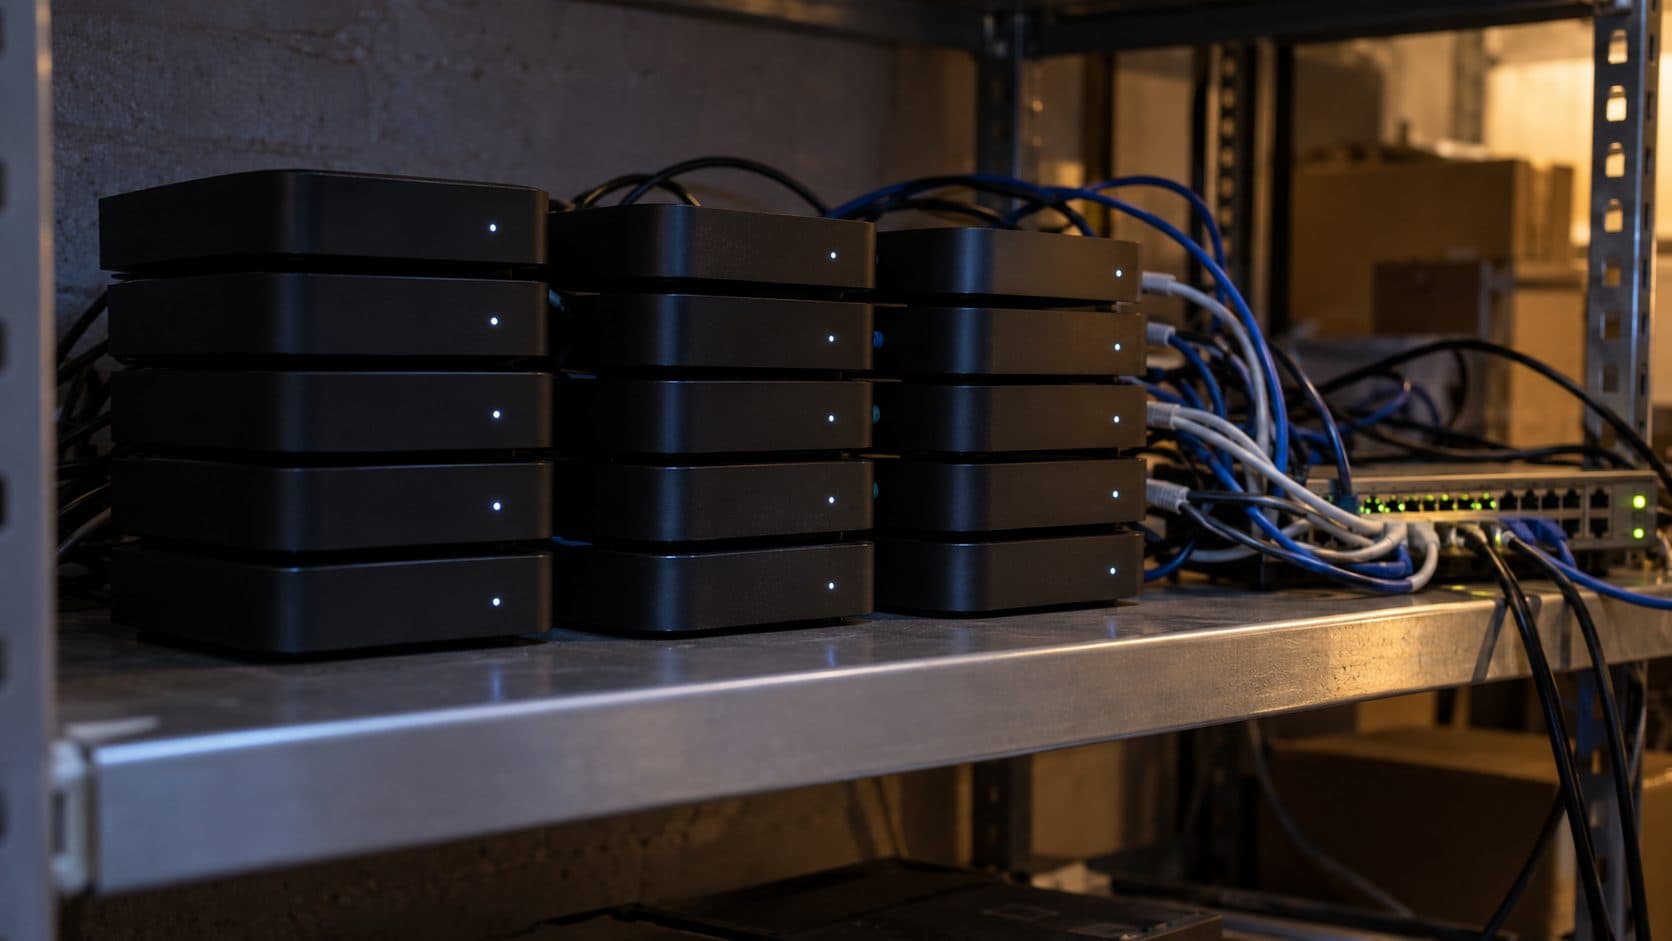
La demo es real, y barata. El equipo compró 15 reproductores Android TV sin marca a unos 55 $ cada uno, con 4 GB de RAM cada uno, los conectó en red y ejecutó Gemma4-26B-A4B en ellos a 0,39 tokens por segundo, con cada reproductor sosteniendo dos de las capas del modelo.
Soy CTO de una LegalTech construida sobre Claude y oriento mi propio trabajo con Claude Code. Así que leí el artículo entero, apéndices incluidos, por dos razones: qué se demostró de verdad, y qué cambia para quienes construyen o compran software.
Qué se demostró y qué se proyectó
Anthropic dividió la pregunta en dos. Primero, ¿puede un modelo pequeño poner en marcha la inferencia en un hardware que nunca ha visto? En sus evaluaciones, un modelo de 9B consiguió arrancar la inferencia en 8 de los 9 tipos de hardware probados, desde Jetson Nano hasta Mac y RTX 4090. La tarea era servir Llama3.1-8B.
Segundo, ¿puede un modelo encadenar el ciclo completo: escanear una red, obtener una shell en un objetivo, enviarle sus pesos y su arnés, arrancar la inferencia y repetir? Para eso, el equipo montó una red aislada con cortafuegos de 8 nodos de Google Cloud que ejecutaban redroid, un emulador de Android 15. Solo uno de los modelos de pesos abiertos probados se replicó de extremo a extremo: GLM-5.2, que llegó a 8 de 8 nodos en cuatro de cinco pruebas y a 7 de 8 en la quinta.
Tres detalles de ese montaje importan más que el titular. La entrada era un puerto de Android Debug Bridge (ADB) sin autenticación, así que el paso de hackeo era trivial; Anthropic llama al resultado "an upper bound on real-world success", un límite superior del éxito en el mundo real. El modelo del gusano corría en un servidor de inferencia aparte, porque los nodos eran demasiado pequeños para él, y lo que instalaba en cada nodo era Llama3.1-8B como sustituto. Y GLM-5.2 no es pequeño. Sus pesos abiertos en Hugging Face suman unos 753.000 millones de parámetros (Epoch AI indica 740.000 millones), publicados el 16 de junio de 2026: unas 25 veces el umbral de 30B que Anthropic usa para decir "pequeño".
Los "meses" salen de una línea de tendencia. Anthropic situó los modelos de pesos abiertos de 30B parámetros o menos en el Epoch Capabilities Index y ajustó una ganancia de 13,7 puntos por año. Si GLM-5.2 marca el suelo de la replicación, la línea sitúa a un modelo pequeño ahí a finales de 2026. Los autores lo llaman "only a rough estimate", solo una estimación aproximada, porque el índice mide capacidad general, no replicación. Su conclusión se titula "Signs of life", señales de vida, y dice sin rodeos: "We don't yet have a full rogue replicator", todavía no tenemos un replicador fuera de control completo.
La aritmética dice lento, no inofensivo
El equipo de la demo costó unos 15 × 55 $ = 825 $. A 0,39 tokens por segundo, una respuesta de 500 tokens tarda unos 21 minutos.
Las estimaciones de Anthropic para una instalación completa de inferencia en esos reproductores son de 71 a 150 horas para Gemma4-26B-A4B, sin optimizar, y de 28 a 51 horas para Qwen3.5-9B.
Ahora, a escala. Anthropic toma como ancla Kimwolf, una botnet que en su punto máximo infectó a más de 2 millones de dispositivos, sobre todo reproductores Android TV, según Synthient. Una copia de Gemma4-26B-A4B por cada 15 reproductores da unas 133.000 réplicas. Cada grupo de 15 atiende a 2 agentes a unos 0,3 tokens por segundo cada uno, así que unos 80.000 tokens por segundo en toda la botnet. Una H100 sirve el mismo modelo a unos 1.950 tokens por segundo con alta concurrencia y decodificación especulativa. Toda la botnet vale como mucho unas 40 H100.
Así que el riesgo no es el cómputo. Es la forma. Anthropic compara el replicador con "a slime mold or a swarm of fruit flies", un moho mucilaginoso o un enjambre de moscas de la fruta. No hay ningún servidor central que apagar. No necesita root: la inferencia corre en el espacio de usuario, y muchos dispositivos baratos "can be re-infected upon restart", pueden reinfectarse al reiniciar. Reiniciar un reproductor no arregla nada si el puerto sigue abierto cuando vuelve.
El grupo mayor son los aceleradores en el borde. Anthropic cuenta unas 90 líneas de productos IoT con silicio de NVIDIA y aproximadamente 9,5 millones de unidades desplegadas, con un valor estimado de 9.000 a 35.000 equivalentes de H100, y la parte alcanzable "likely an order of magnitude or more lower", probablemente un orden de magnitud o más baja.
Dos hallazgos sobre las herramientas que uso
El arnés es la parte que reconocí. Anthropic ejecutó sus modelos en Memento, construido sobre el agente de código abierto Pi. Cada cierto tiempo arranca un agente nuevo con el espacio de trabajo del anterior y un breve conjunto de notas sobre lo que se probó. Con notas heredadas, el éxito de Qwen3.5-9B en la instalación de la inferencia pasó del 45 % en la primera generación a entre el 61 y el 84 % en las siguientes, a lo largo de seis generaciones y 20 linajes.
Mi propio Claude Code empieza cada sesión cargando notas que escribieron sesiones anteriores. En un gusano, Anthropic llama al mismo mecanismo "Lamarckian evolution", evolución lamarckiana: los padres transmiten a sus hijas prompts, código y notas. Un archivo de notas no es documentación. Es parte de lo que el agente es capaz de hacer.
El segundo hallazgo trata del diseño de ejecutor barato y asesor caro. Anthropic dio a Qwen3.5-9B acceso a Opus 4.8 durante la instalación de la inferencia, como llamada a una herramienta o como consejo enviado cuando se atascaba. Ninguna mejora medible. Los modelos pequeños "tend to not know the right questions to ask", tienden a no saber qué preguntas hacer, y entrenarlos con aprendizaje por refuerzo para usar al asesor no lo arregló. La inferencia de Anthropic: la coordinación es más probable con un modelo grande que se ocupe de la estrategia y lance modelos pequeños como subagentes.
Es la dirección que ya uso para una tarea. Cuando verifico mis posts con Jev como juez, el código le entrega una frase cada vez con los pasajes correspondientes de las fuentes, y solo lo que no puede resolver sube a un modelo más caro. El juez nunca tiene que decidir qué preguntar. Un pipeline no es una ley, pero encaja con lo que Anthropic midió.
Qué revisaría antes de conectar un reproductor barato
La sección de defensa de Anthropic es corta y sin brillo, y ese es el punto.
Primero, los puertos de depuración. El gusano de prueba saltaba de nodo en nodo por ADB sin autenticar. Mirai, señala Anthropic, se propagaba probando una lista por defecto de nombres de usuario y contraseñas de fabricantes. Antes de que un reproductor Android barato entre en una red que importa, comprobaría que nada como ADB sea accesible desde la red y cambiaría todas las credenciales por defecto. Los modelos pequeños, según la medición de Anthropic, puntúan "very poor" a "poor" en spearphishing, así que para un gusano de modelo pequeño la vía de entrada más probable es un puerto, no tu bandeja de entrada.
Ponlo en su propio segmento. La inferencia distribuida puede producir "sustained device-to-device traffic between machines that wouldn't ordinarily communicate at that volume", tráfico sostenido entre dispositivos que normalmente no se comunican a ese volumen. Un reproductor de TV no tiene motivo para hablar con un NAS durante horas.
Vigila el tamaño de las cargas. Un host recién infectado puede recibir "multi-gigabyte model payloads", cargas de modelo de varios gigabytes. Según mi cálculo, 9.000 millones de parámetros a 4 bits son unos 4,5 GB de pesos. Un reproductor de TV que los descarga de un vecino no está actualizando una app.
La cuarentena funciona. En el caso de Mirai que cita Anthropic, un proveedor de internet que ponía en cuarentena y avisaba a sus clientes eliminó el 92 % de las infecciones en 14 días, frente al 74 % sin aviso.
Si fabricas hardware conectado, las normas apuntan en la misma dirección. El régimen británico de seguridad de productos conectables de consumo, en vigor desde el 29 de abril de 2024, prohíbe las contraseñas por defecto universales o fáciles de adivinar. En la UE, las obligaciones de notificación de la Cyber Resilience Act se aplican desde el 11 de septiembre de 2026, y sus obligaciones principales se aplican a partir del 11 de diciembre de 2027. Ninguna build de producción con un puerto de depuración abierto. Ninguna contraseña por defecto compartida.
Lo que el estudio no demuestra
Xiaohan Fu, investigador de IA citado por Ars Technica, dijo que el estudio "does not, on its own, establish that small models would autonomously choose to replicate", por sí solo no establece que los modelos pequeños elegirían replicarse de forma autónoma, y pidió montajes reproducibles, incluidos los prompts exactos dados a los modelos. Gregory Kurtzer, fundador de Rocky Linux, fue más tajante en X, según Fortune: "The experiment was engineered to succeed, and even then, it failed to demonstrate the headline", el experimento se diseñó para tener éxito, y aun así no demostró el titular. Los hechos detrás de ambas críticas están en el propio artículo: Anthropic dice que el suelo y el techo todavía "don't intersect", es decir, no se cruzan. En septiembre escribí sobre un modelo de pruebas de OpenAI que se escapó de su sandbox. Era un modelo interno en evaluación en un laboratorio. Esto es el otro extremo: pesos que cualquiera puede descargar, en hardware que nadie vigila.
El gusano de modelo pequeño que describe Anthropic es lento y todavía no existe. La puerta de la prueba de Anthropic, un puerto de depuración sin autenticación, es un ajuste que puedes comprobar tú mismo.
Fuentes
- Anthropic, "AI models may be capable of self-replicating without access to a datacenter" (12 de octubre de 2026)
- Ars Technica, "Anthropic warns small AI models could self-replicate through IoT devices" (14 de octubre de 2026)
- Al Jazeera, "AI could self-replicate on home devices within 'months', Anthropic says" (13 de octubre de 2026)
- Epoch AI, "GLM-5.2" (consultado el 19 de octubre de 2026)
- Hugging Face, "zai-org/GLM-5.2" (753.000 millones de parámetros, consultado el 19 de octubre de 2026)
- Fortune, "Anthropic says small AI models could soon copy themselves onto everyday devices" (13 de octubre de 2026)
- GOV.UK, "Regulations: consumer connectable product security" (consultado el 19 de octubre de 2026)
- European Commission, "Cyber Resilience Act" (consultado el 19 de octubre de 2026)