
Unos 1.500 MW de centros de datos salieron de la red de golpe. Lo hizo su propia protección, no la de la red.
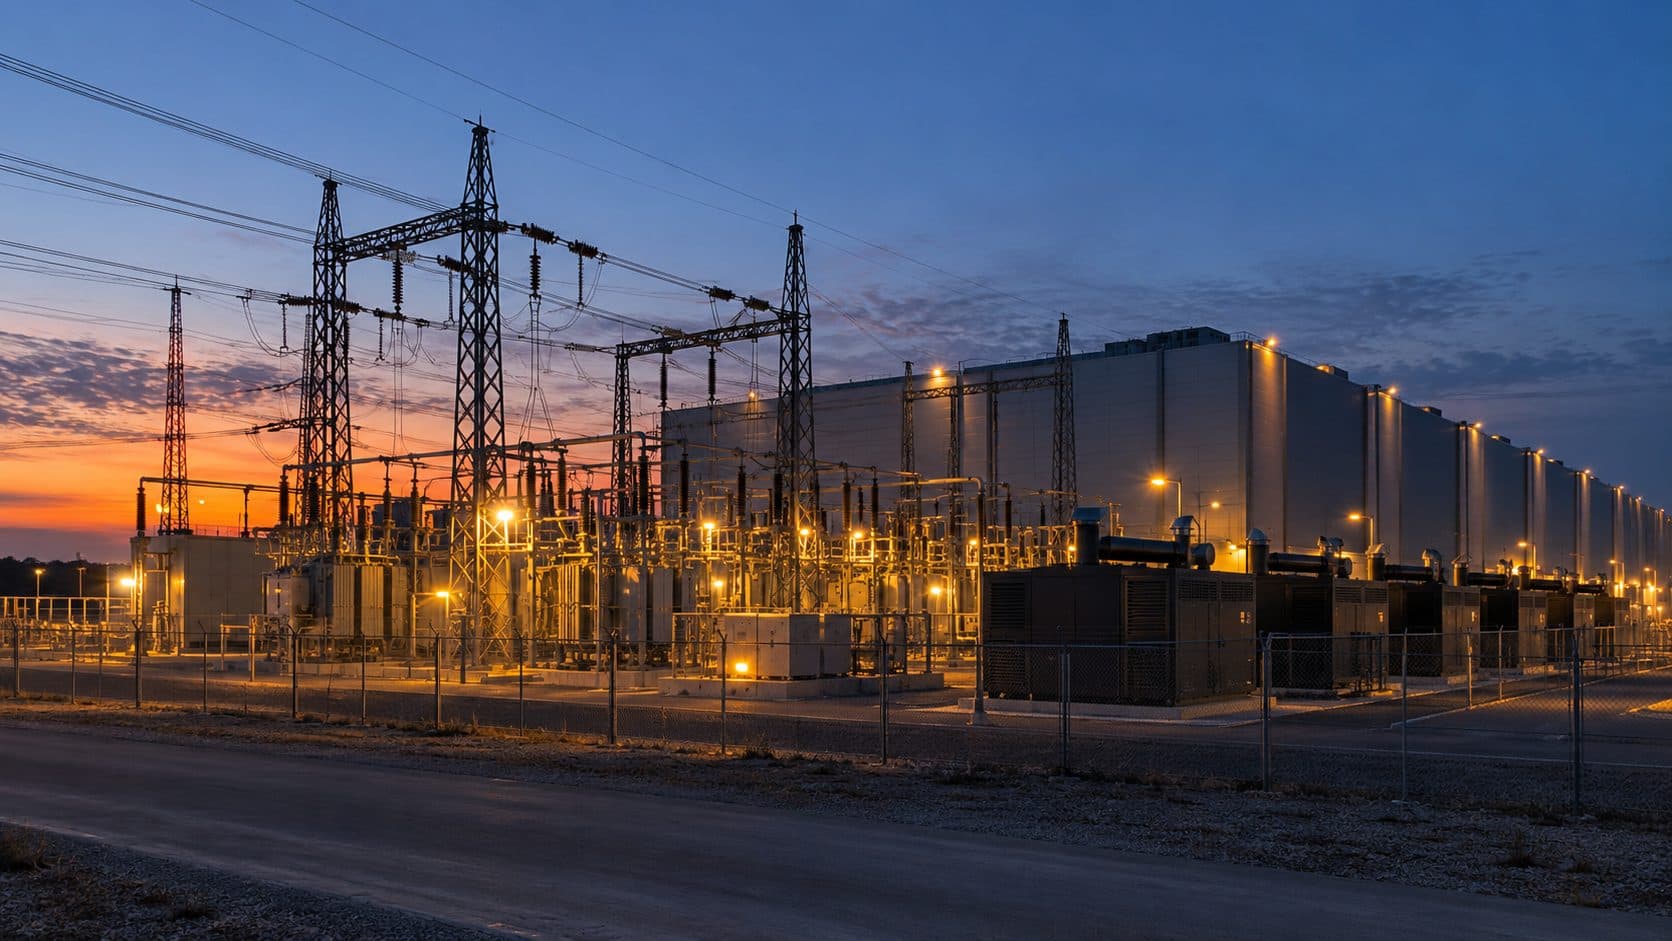
Hacia las 19:00, hora del Este, del 10 de julio de 2024, falló un pararrayos en una línea de transmisión de 230 kV de la Interconexión del Este. Un borrador posterior de un grupo de trabajo de la NERC sitúa la línea en el territorio de servicio de Dominion Energy, en Virginia. La falla era permanente, y los interruptores de la línea hicieron lo que están configurados para hacer: reabrir y volver a intentarlo, tres veces en cada extremo, antes de bloquear la línea. Eso son seis fallas en 82 segundos. El sistema de protección detectó y despejó cada una correctamente, la más larga en 66 milisegundos.
En la misma zona local, desaparecieron unos 1.500 MW de carga. Ninguna fue desconectada por equipos de la compañía eléctrica, y los operadores de la red no lo habían anticipado. Todo era carga de centros de datos, retirada de la red por las protecciones y los controles de los propios clientes.
La NERC, que redacta y hace cumplir las normas de fiabilidad de la red bajo la supervisión de la FERC, publicó su revisión del incidente el 8 de enero de 2025. El 16 de julio de 2026, la FERC ordenó a la NERC presentar las primeras normas obligatorias para las "cargas computacionales" (computational loads) antes del 31 de diciembre de 2026. El 15 de octubre, la NERC anunció que sus normas propuestas habían pasado la votación final del sector. Entre medias, un evento mayor golpeó la misma región.
Leí la revisión del incidente, la orden de la FERC, los borradores de normas y las diapositivas del operador de la red sobre el evento de julio de 2026. Aparte de la falla de hardware que inició cada evento, ninguno describe un fallo de protección. Del lado de la red, cada falla se despejó como estaba diseñado. Del lado de los clientes, en 2024, la NERC atribuyó la mayor parte de la pérdida a una regla que hacía justo para lo que está construida.
Seis fallas, tres caídas, una regla
El reenganche automático es el "retry" de la red: si la falla era temporal, la línea vuelve sola. Durante cada una de las seis fallas, la tensión en la zona de carga cayó entre 0,25 y 0,40 por unidad, de un 25 a un 40 % de lo normal, durante 42 a 66 milisegundos.
Los centros de datos atraviesan caídas como estas con sistemas de alimentación ininterrumpida (UPS). La NERC describe tres diseños: UPS centralizados de 2 a 5 MW, unidades a nivel de rack de 3 a 4 kW, y UPS rotativos diésel, un volante de inercia que sostiene la carga mientras arranca un motor diésel. Un UPS de baterías devuelve la carga a la red cuando la tensión se recupera. El rotativo no: la transferencia de vuelta suele ser manual.
Luego hay una regla por encima de todo eso. Las conversaciones con los propietarios de los centros de datos, escribe la NERC, identificaron un esquema que cuenta las perturbaciones de tensión. En palabras de la NERC: "El número típico de perturbaciones de tensión que activan este esquema es tres, y un tiempo típico es un minuto." Una vez activado, el sitio pasa a la alimentación de respaldo y se queda ahí hasta que alguien lo reconecta manualmente.
Veamos ahora las marcas de tiempo. La primera caída llegó a las 19:00:23,351. El reenganche instantáneo en ambos extremos causó la segunda a las 19:00:23,883. El segundo reenganche en un extremo causó la tercera a las 19:00:39,211, 15,86 segundos después de la primera. Tres caídas en menos de 16 segundos, de sobra dentro de una ventana de un minuto.
En esa tercera caída, unos 1.260 MW salieron de la red "y no volvieron durante horas". La NERC atribuye la mayor parte de la pérdida de carga del evento a "la interacción entre la secuencia de reenganche automático" y el esquema de conteo de caídas.
Lo que sintió la red
Cuando desaparece carga, la generación supera brevemente a la demanda y la frecuencia sube. Con menos corriente por las líneas, la tensión también sube. La frecuencia alcanzó un máximo de 60,047 Hz y se estabilizó en unos cuatro minutos. La tensión llegó a 1,07 por unidad, un 7 % por encima del nominal, y los operadores retiraron bancos de condensadores en derivación para bajarla.
La NERC es clara en que ninguno de los dos niveles fue un riesgo para la fiabilidad esta vez. Su preocupación es la escala: la red "históricamente se ha planificado para grandes pérdidas de generación pero no para pérdidas de carga simultáneas tan significativas". También señala el viaje de vuelta: "Las rampas de conexión de la carga son tan críticas para la operación del sistema como las rampas de generación."
22 de julio de 2026: la misma forma, más grande
A las 07:56 del 22 de julio de 2026, una línea de 230 kV tuvo una falla en la zona Dominion de PJM, el operador regional de la red. Las conclusiones preliminares de Dominion, presentadas al comité de operaciones de PJM el 6 de agosto, dicen que un subconductor se soltó de un manguito de compresión, y la causa aparente fue el sobrecalentamiento del manguito por pernos mal apretados. La falla y cada reenganche se despejaron en 2 a 3 ciclos, unos 33 a 50 milisegundos a 60 Hz. "Todos los sistemas de protección funcionaron como estaba diseñado, aislando la línea con falla."
Una primera ola de unos 2.970 MW pasó a alimentación de respaldo. La diapositiva de PJM describe el paso siguiente: "La transferencia de carga causó condiciones de alta tensión y desencadenó la transferencia de carga adicional a generación de respaldo." Siguió una segunda ola de 1.099 MW. PJM cifró el total en unos 3.800 MW en agosto y en unos 3.900 MW en sus diapositivas del 6 de octubre: en cualquier caso, la mayor transferencia de carga que ha vivido. La carga de su sistema cayó de 99.984 MW a 96.205 MW, un 3,8 % aproximadamente. La frecuencia llegó a 60,092 Hz. PJM devolvió su error de balance a los límites en 9 minutos, frente a un requisito de 30 minutos, y la carga volvió en 30 minutos.
Estas conclusiones son preliminares, y las cifras de las olas no suman exactamente el total. La cronología de Dominion sitúa la primera ola en mitad de la secuencia de reenganche. PJM califica la transferencia de "probablemente debida al desempeño de tolerancia a caídas de tensión (voltage ride-through)"; las diapositivas no dicen que un contador de caídas estuviera implicado. Lo que sí muestran es un bucle de realimentación: un grupo de sitios que se protegía creó la sobretensión que hizo disparar al siguiente grupo. "Esta fue una falla despejada con normalidad", dijo Emanuel Bernabeu, presidente del comité de operaciones de PJM. "No deberían desconectarse de la red."
Qué hacen las primeras normas, y qué dejan fuera
La orden de la FERC pide a la NERC normas de "acciones esenciales" y criterios de registro antes del 31 de diciembre de 2026, y un plan de trabajo para una segunda fase antes del 1 de marzo de 2027, "con mayor certeza que la que ofrecen los plazos voluntarios".
El paquete, cuya votación final se cerró el 14 de octubre, crearía tres normas nuevas, CLO-001-1, CLO-002-1 y CLO-003-1, para sitios de 50 MW o más conectados a 100 kV o más. Las preguntas frecuentes de la NERC dicen que buscará la aprobación de su Junta en diciembre y luego presentará a la FERC. CLO-001-1 incorpora la lógica de disparo al modelo de planificación: los datos de modelado deben incluir "parámetros, ajustes y capacidades relacionados con el cese, el disparo, la tolerancia a perturbaciones (ride-through) y la recuperación posterior a la perturbación", y los propietarios deben volver a verificar sus modelos en los 180 días siguientes a un cambio de hardware, software, firmware o ajuste que altere la respuesta dinámica del sitio. CLO-003-1 exige registradores de perturbaciones en el transformador principal del sitio, registro continuo muestreado al menos 960 veces por segundo y relojes a menos de 1 milisegundo del UTC. Los sitios existentes tienen 36 meses desde la fecha de entrada en vigor para los registradores.
Lo que el paquete no fija es un ride-through mínimo para todo el sector. Las preguntas frecuentes de la NERC dicen que "no aborda ningún requisito de tolerancia mínima de tensión y frecuencia para todo el sector". Una solicitud en borrador del grupo de trabajo de grandes cargas de la NERC, publicada para comentarios el 26 de agosto, propone una envolvente de desempeño (por ejemplo, aguantar al menos 0,5 segundos a 0,5 a 0,8 por unidad) y contiene una frase que se lee como una respuesta a julio de 2024: el "umbral" de un contador de caídas "debería tener en cuenta la secuencia de reenganche automático esperada en el sistema de transmisión que atiende al sitio". También señala que sitios de la misma subestación, golpeados por caídas casi idénticas, se comportaron de forma distinta, de modo que los planificadores "no pueden predecir actualmente cuánta carga retirará de servicio una falla creíble". La actualización del tercer trimestre de la NERC dice que el grupo planeaba llevar una versión final a los comités de la NERC los días 20 y 21 de octubre; las palabras citadas aquí son del borrador de agosto. PJM propuso sus propios requisitos de ride-through el 8 de septiembre.
Lo que me llevo
No diseño subestaciones. Como CTO de una LegalTech construida sobre Claude, lanzo software que depende de los servicios de otras personas, y la forma me resulta familiar. Solo como analogía: el reenganche es una política de retry, el contador de caídas es un circuit breaker del lado del cliente. Cada uno es razonable por separado. Con dueños y ajustes distintos, el retry cumplió la condición de disparo del breaker en menos de 16 segundos, en todos los sitios que lo usaban y veían las mismas caídas.
Lo que copiaría:
- Pon los números lado a lado. Escribe el calendario de retry de cada dependencia junto a tu propio umbral de disparo. El borrador del grupo de trabajo pide exactamente eso: dimensionar el contador según la secuencia de reenganche.
- Prueba la flota, no la unidad. La alerta de la NERC del 4 de mayo de 2026 pidió a los planificadores encontrar las contingencias creíbles en las que la pérdida agregada de carga computacional, incluida la iniciada por los clientes, violaría los criterios de planificación. En software, reproduce la secuencia real de fallo de una dependencia contra todos los clientes a la vez.
- Trata los ajustes como código. CLO-001-1 trata un cambio de ajuste como un cambio de equipo. Un timeout merece la misma revisión que un commit.
- Registra en la frontera, con un solo reloj. En 2024, la causa salió de conversaciones con los propietarios de los centros de datos. Registradores sincronizados en la interfaz permitirían a la próxima revisión comprobar la secuencia con datos.
- Planifica la vuelta. Los UPS rotativos y los contadores de caídas suelen requerir una transferencia manual de vuelta, y la NERC advierte sobre las rampas de reconexión. Que todos los clientes se reconecten a la vez es un incidente en sí mismo.
La evidencia tiene límites. La revisión de la NERC no nombra a ningún operador y no publica los ajustes de ningún sitio, y las conclusiones de Dominion de 2026 son preliminares: sus diapositivas anunciaban un análisis formal de causa raíz para septiembre de 2026. PJM dice que la red no sufrió impactos significativos de fiabilidad el 22 de julio de 2026. El riesgo es la tendencia: unos 1.500 MW en julio de 2024, unos 1.800 MW en febrero de 2025 y unos 3.900 MW en julio de 2026 según el recuento de octubre de PJM, y sitios existentes, no futuros, detrás de cada evento documentado hasta ahora, según la solicitud en borrador.
La red cumplió su promesa de reintentar. Los centros de datos cumplieron su promesa de protegerse. Nadie del lado de la red había anticipado lo que harían las dos promesas juntas.
Fuentes
- NERC, "Incident Review: Considering Simultaneous Voltage-Sensitive Load Reductions" (8 de enero de 2025)
- FERC, "Order Directing the North American Electric Reliability Corporation to File Reliability Standard(s) Pertaining to Computational Load Integration", Docket No. RD26-7-000 (16 de julio de 2026)
- NERC, "Level 3 Alert, Essential Action to Industry: Computational Load Modeling, Studies, Instrumentation, Commissioning, Operations, Protection, and Control" (4 de mayo de 2026)
- NERC, "NERC's Computational Loads Standards Pass Final Ballot, Advance to Board Adoption" (15 de octubre de 2026)
- NERC, "CLO-001-1, Computational Load Interconnection, Studies, & Modeling Data, final draft" (octubre de 2026)
- NERC, "CLO-003-1, Computational Load Protection Coordination & Disturbance Monitoring, final draft" (octubre de 2026)
- NERC, "CLO-003-1 Implementation Plan" (octubre de 2026)
- NERC, "Project 2026-02 Computational Loads FAQ" (octubre de 2026)
- NERC Large Loads Working Group, "Standard Authorization Request: Reliability Standards to Address Computational Load Disturbance Performance (draft)" (publicado el 26 de agosto de 2026)
- NERC, "Large Loads Action Plan, Q3 2026 Update" (14 de octubre de 2026)
- PJM, "PJM Large Computational Load (LCL) Operational Review", Planning Committee (6 de octubre de 2026)
- PJM, "July 22, 2026 Dominion Load Transfer Event" (con las conclusiones preliminares de Dominion Energy) (6 de agosto de 2026)
- PJM Inside Lines, "PJM, Dominion Review Large Load Transfer Event" (11 de agosto de 2026)
- PJM Inside Lines, "PJM Proposes Reliability Standards to Manage Large Load Disconnection Events" (10 de septiembre de 2026)